

DeepSeek опять напомнили всем, что они короли опенсорса, и выложили движок, на…
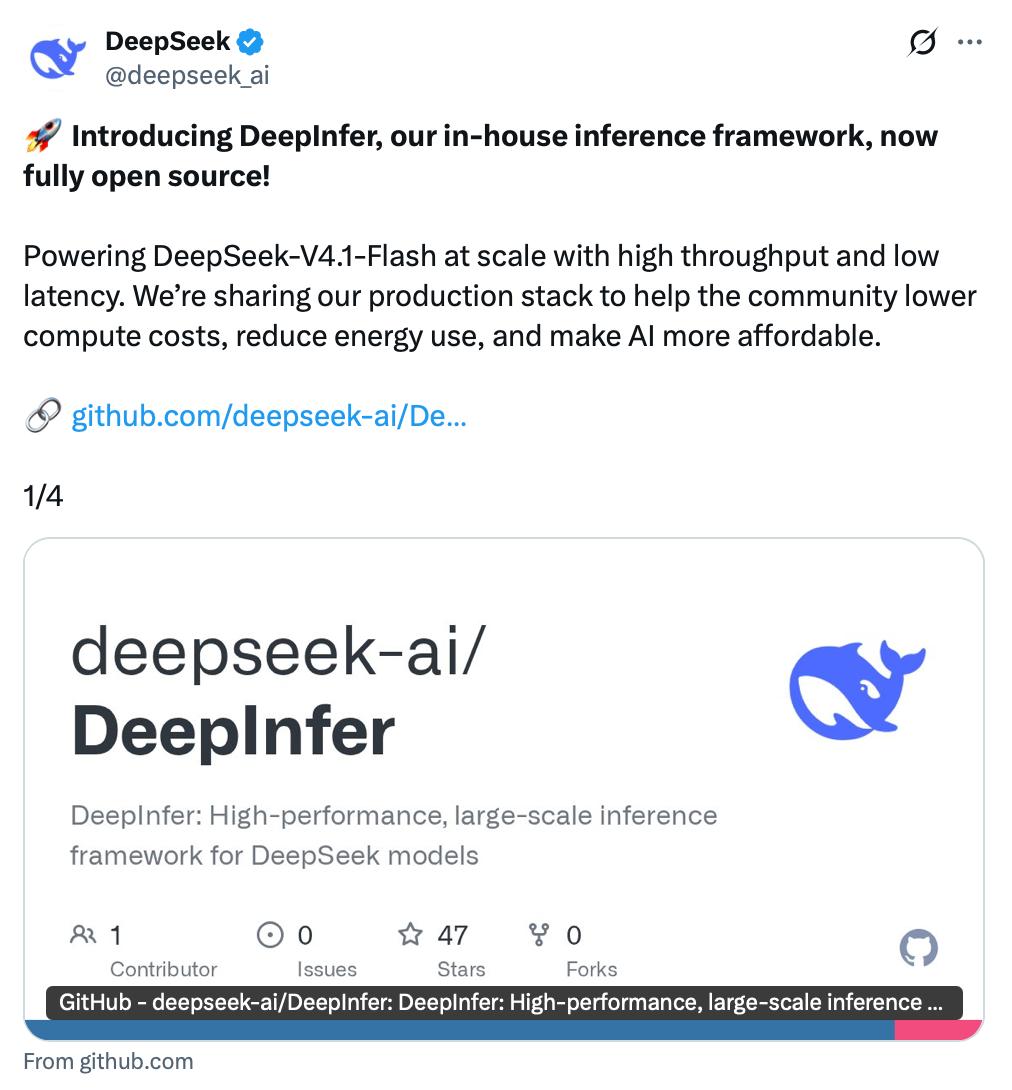
DeepSeek опять напомнили всем, что они короли опенсорса, и выложили движок, на котором крутят свой инференс
Стартап опубликовал DeepInfer – фреймворк, на котором работают их продакшн-сервисы. Лицензия Apache-2.0: github.com/deepseek-ai/DeepInfer.
В основе собственные оптимизированные кернелы (FlashMLA, DeepGEMM, DeepEP и др), параллелизм под MoE-архитектуру и асинхронный планировщик, который готовит следующий батч, пока устройство считает текущий. И помимо этого куча фичей для оптимизации и просто интересных штук, которые можно забрать себе. Например:
1. Спекулятивный декодинг. Модель генерирует несколько draft-токенов, а затем проверяет их разом, решая, какие пропустить в итоговый ответ, а какие надо переделать. Это ускоряет и удешевляет инференс.
2. Схема детерменизма для отладки всяких пайплайнов и эвалов поверх LLM. Фишка в том, что, в отличие от обычного режима работы модели, тут одинаковый вход и параметры дают всегда одинаковый результат вне зависимости от нагрузки и состава батча.
3. Structured outputs, с помощью которого можно жестко ограничить генерацию JSON, регуляркой или EBNF.
Также под лицензией MIT выложили deepseek-recipe, то есть схему, по которой запрос от клиента превращается в то, что понимает модель, а ответ модели обратно в то, что ждет клиент (на этом довольно часто ломается самостоятельный хостинг открытых весов). Есть Python-биндинг, для практики очень полезная вещь.
Материалы по теме

Плейсментами дело не ограничилось 😮 Недавно я писал, что в новом интерфейсе…
❌ MEXC прекращает обслуживание пользователей из РФ и Беларуси Вслед за Bitget…






Вставить свои 5 копеек: