

Клоакинг в SEO: money/white, защита от абузеров и РКН
Абуза от правообладателя, хостер блокирует сервер, и вебмастер уже ставит клоаку. Механика money/white, ловушка с прокси Google, система детекта с точностью 95,5% и реальная цена вопроса.
- Зачем клоака в грей-SEO
- Money page и white page: кого куда и почему
- Как реализуют клоакинг в Black Hat SEO
- Ловушка, о которой не знают: прокси самого Google
- Защита от абузов и блокировок в сером SEO
- Как клоакинг в SEO палится
- Где проходит граница дозволенного при настройке клоаки в SEO
- Риски и цена
- Чек-лист оценки рисков
- Куда двигаться дальше
Про клоакинг обычно говорят в контексте платного трафика: показать модератору рекламной сети одну страницу, а пользователю другую. В SEO он живет другой жизнью, так как и мотивация другая — клоака в SEO чаще работает не мечом, а щитом от жалоб правообладателей, парсеров конкурентов и блокировок.
Типичная история выглядит так. Вебмастер делает монобрендовые сайты, прилетает жалоба от правообладателя: товарные знаки, логотипы, имя бренда — все защищено. Контент можно переписать, логотипы перерисовать, а вот вхождение бренда в доменное имя уже никуда не денешь. Хостер блокирует сервер. И вебмастер приходит к мысли: а что если сайт будет открываться только поисковому боту и целевому пользователю, а всем остальным — нет?
Разберем, как это устроено, зачем нужно, как детектится и чем заканчивается. Официальную рамку берем из документации и исследований Google, практику — из канала TRAFF NOT DEAD, где разбирали реальные внедрения.

Сразу о границе жанра: ниже нет ни готовых скриптов, ни обещаний, что никто никогда и ничего не обнаруживают. Такие обещания продают вам что-то, и в большинстве случав не соответствуют действительно — детект существует, и заканчивается он не предупреждением, а выпадением из выдачи.
Зачем клоака в грей-SEO
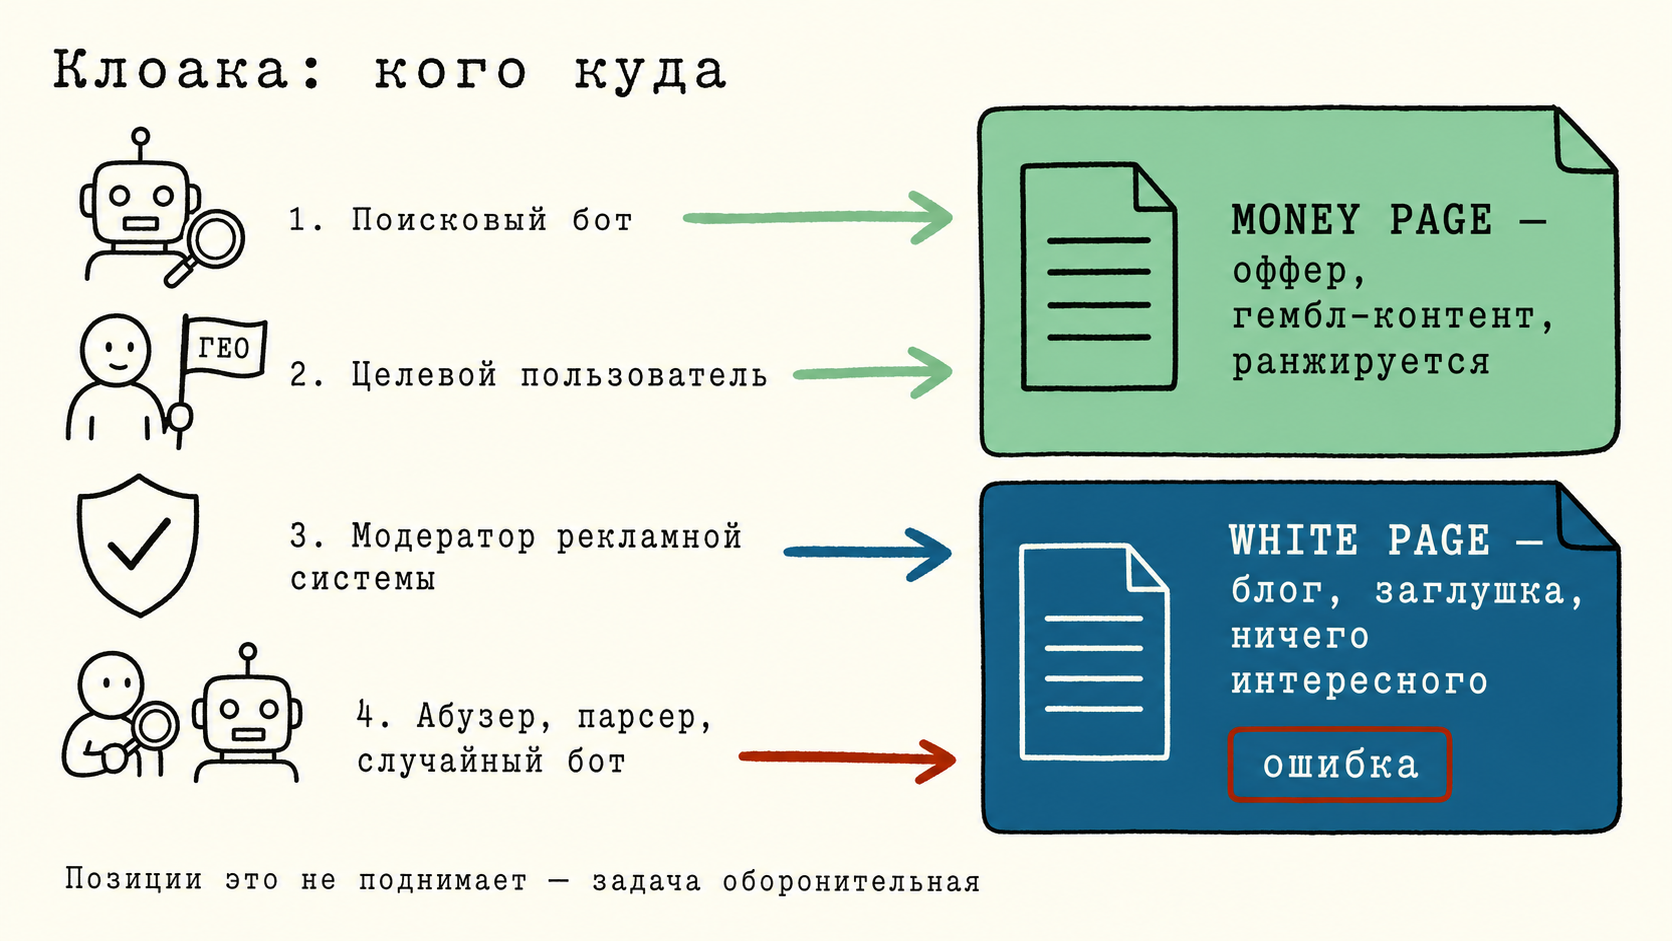
Типы, которых клоака разводит по разным страницам: поисковый бот, целевой пользователь и все остальные
Причина существования — расхождение двух задач:
- Поисковику надо показать страницу, которая ранжируется по целевым запросам.
- А всем остальным желательно не показывать ничего, потому что «все остальные» в грее — это чаще всего не покупатели.
Кто приходит на грей-сайт кроме поисковика и игрока:
- Правообладатели и их подрядчики — собирают доказательства для жалоб на использование бренда, товарных знаков и логотипов.
- Парсеры конкурентов — снимают структуру, контент и ссылочные схемы.
- Проверяющие и модераторы — смотрят, что реально на странице.
- Просто боты — сканеры, чекеры, краулеры сервисов аналитики.
Логика вебмастера простая: если сайт не открывается тому, кто собирает доказательства, то и жалоба не формируется. Как формулирует автор TRAFF NOT DEAD: когда «пробивала» видит белый экран, он скорее решит, что сайт нерабочий, и закроет вкладку.
Отдельная мотивация — блокировки. В ГЕО со строгим регулятором логика та же: фильтровать, кого пускать, и не отсвечивать перед теми, кто заносит домены в реестры.

Важно понимать: это оборонительная мотивация, а не способ поднять позиции. Клоака ничего не улучшает в ранжировании — она снижает вероятность того, что сайт заметят и заблокируют раньше времени. Это отсрочка, а не решение.
Money page и white page: кого куда и почему
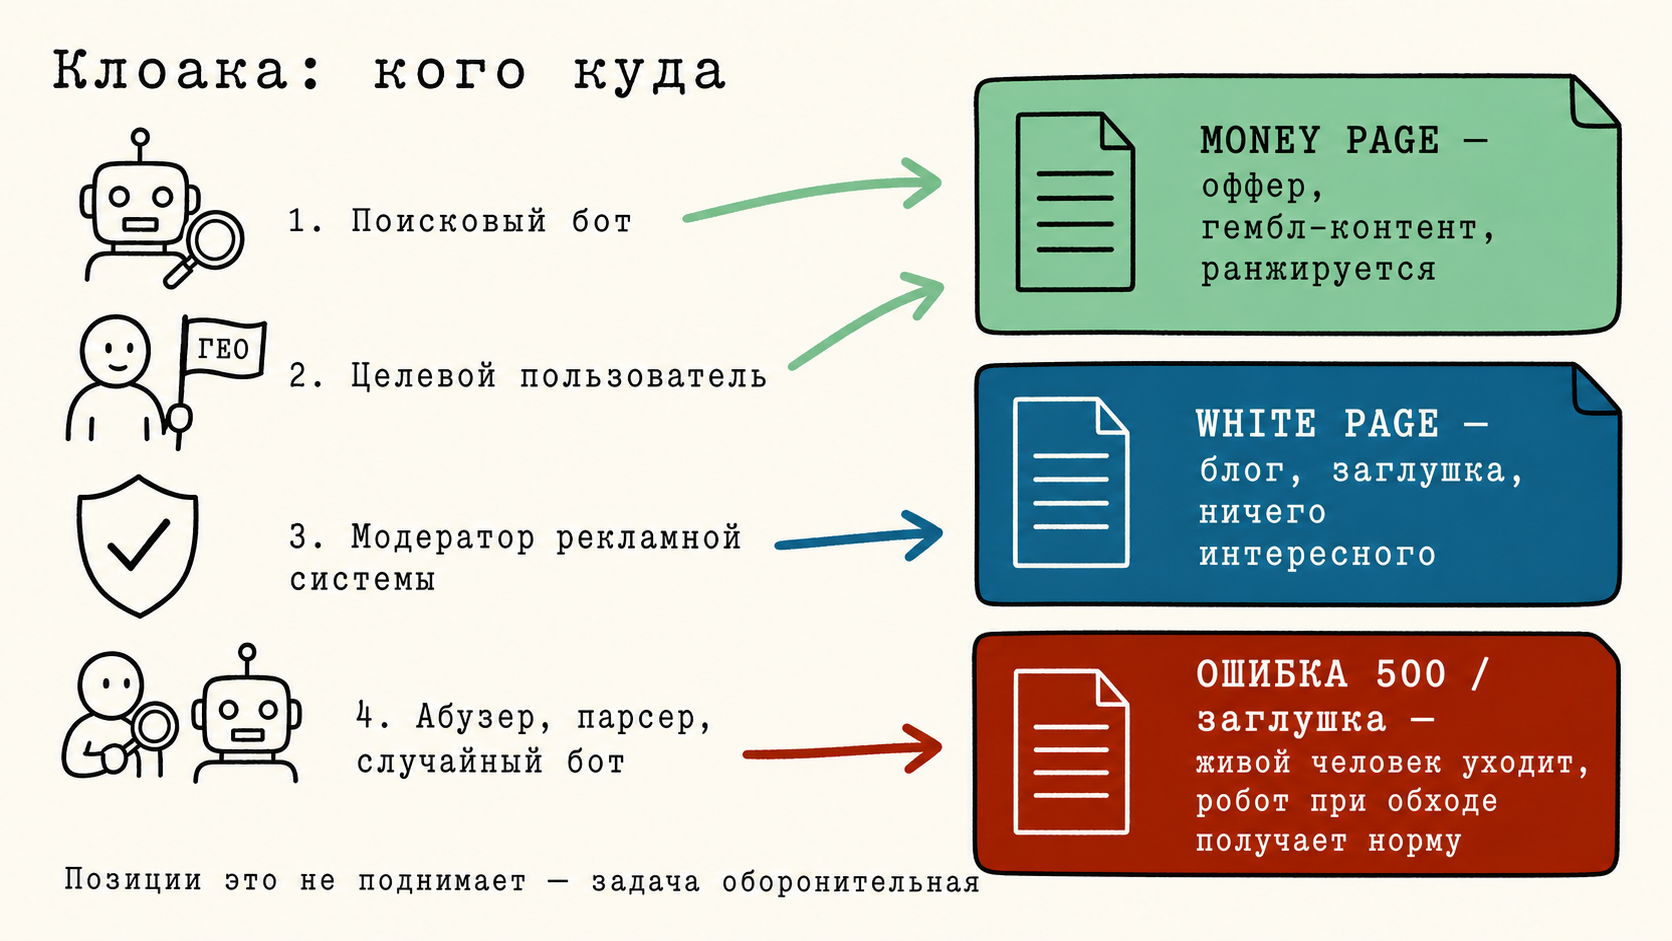
Четыре типа посетителей, которых клоака разводит по разным страницам: поисковый бот, целевой пользователь и все остальные
Базовая механика описывается двумя страницами.
Money page — целевая страница, ради которой все затевалось: гембл-контент, оффер, ссылки на партнерку. Именно она должна попадать в индекс и ранжироваться.
White page — безобидная страница-заглушка: блог, инфосайт, «страница в разработке». Ее показывают тем, кому money page видеть не следует.
Дальше начинается разведение потоков. В том виде, как это описывают практики, схема выглядит так:
- Краулеры поисковиков (Google, Яндекс, Bing) → money page. Иначе сайт не проиндексируется и не будет ранжироваться.
- Модерирующие боты рекламных систем → white page. По наблюдениям практика, тестировавшего свою реализацию, краулеры Google стабильно попадали на манисайт, а модератор рекламной системы — на вайт.
- Целевой пользователь (нужное ГЕО, переход из поиска, обычный браузер и устройство, без прокси) → money page.
- Все остальные → white page или ошибка.
Самый грубый вариант последнего пункта — отдавать всем, кроме списка разрешенных ботов, серверную ошибку. Живой человек видит «500 Internal Error» и уходит, а робот при обходе получает нормальную страницу и позиции не теряются. Работает это ровно до тех пор, пока трафика на сайте нет, — то есть на стадии, когда домен только набирает позиции. У метода есть и неочевидная цена: как поведет себя регистратор домена, если жалоба все-таки дойдет до него, предсказать нельзя.
Как реализуют клоакинг в Black Hat SEO
Технически подмена возможна на трех уровнях, и разница между ними — в том, где принимается решение.
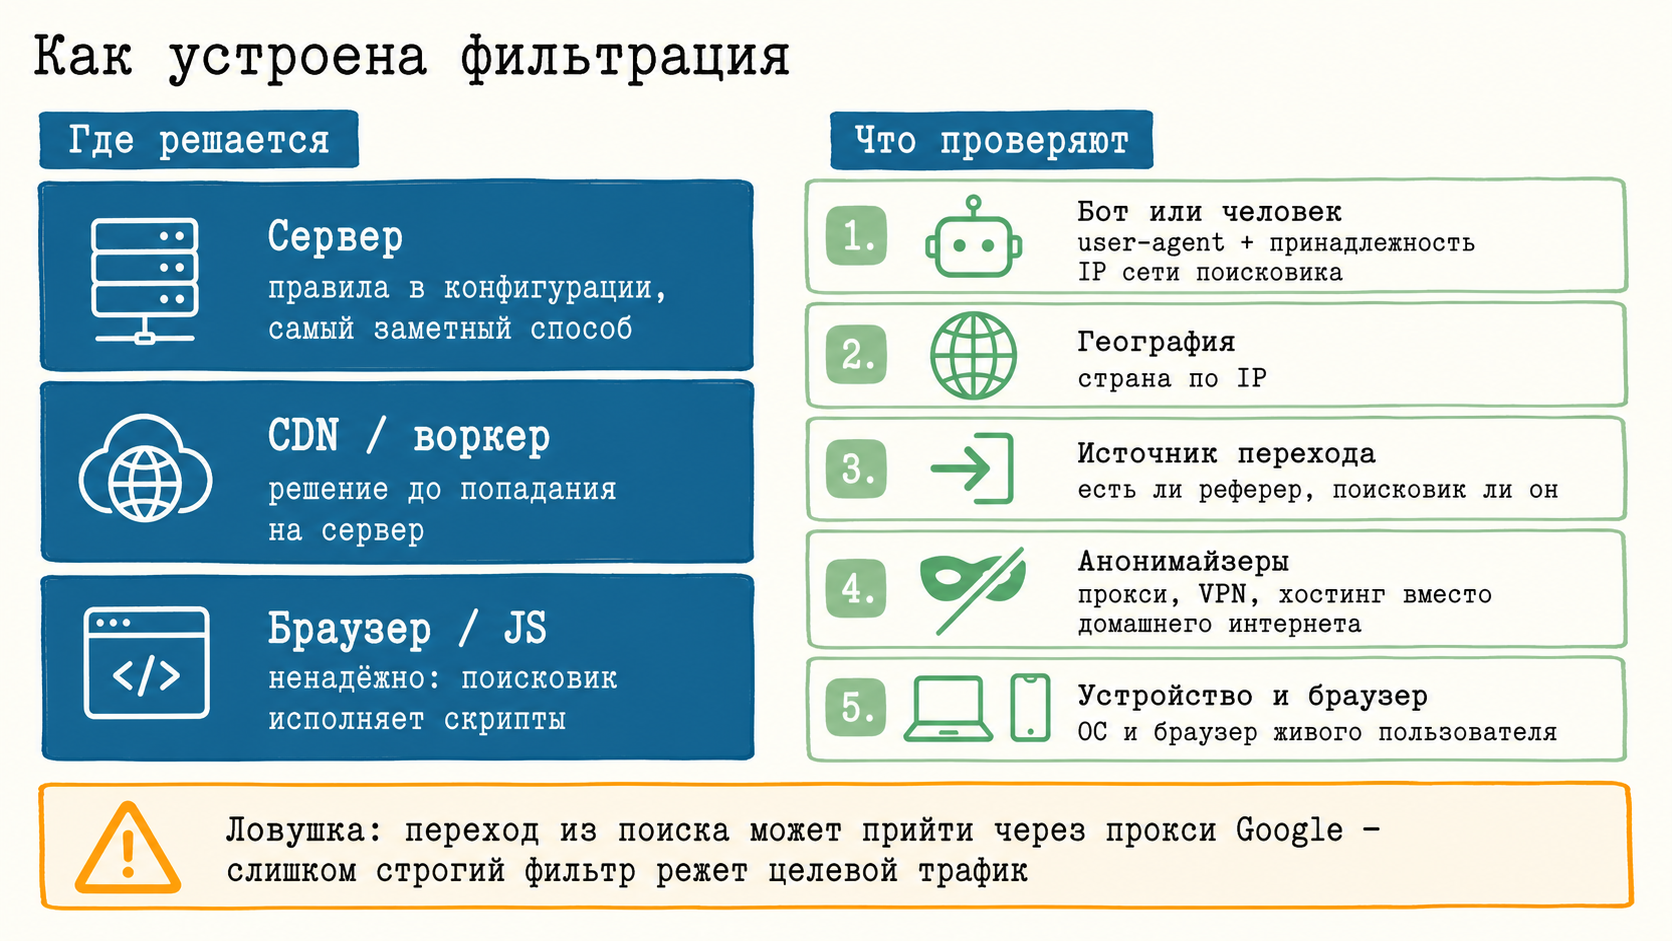
Пять измерений, по которым фильтруют посетителя, и уровни, на которых принимается решение
На уровне сервера. Правила в конфигурации веб-сервера смотрят на признаки запроса и решают, что отдать. Самый старый и самый заметный способ.
На уровне CDN. Скрипт выполняется на стороне сети доставки — например, в Cloudflare Worker. Удобно тем, что решение принимается до того, как запрос дойдет до вашего сервера, и в одном месте живет вся логика фильтрации.
На уровне браузера. Подмена через JavaScript уже после загрузки страницы. Наименее надежный вариант: поисковик исполняет JavaScript и видит результат.
По каким измерениям проверяют посетителя — это, собственно, и есть вся содержательная часть:
| Проверка | Что смотрят |
| Бот или человек | User-agent, принадлежность IP к сети поисковика |
| География | Страна по IP: целевое ГЕО или нет |
| Источник перехода | Есть ли реферер и является ли он поисковиком |
| Анонимайзеры | Признаки прокси, VPN, хостинг-провайдера вместо домашнего интернета |
| Устройство и браузер | Тип ОС и браузера, соответствуют ли живому пользователю |
Типичный набор правил в описанной практиками реализации пропускает поисковых ботов и пользователей из целевого ГЕО, пришедших из поиска на обычном устройстве без прокси, — и блокирует все остальное: непоисковых ботов, заходы из нецелевых стран, прямые заходы без реферера, трафик с прокси и хостингов.
Ловушка, о которой не знают: прокси самого Google
Здесь есть неочевидная вещь, на которой ломаются самодельные реализации. Автор TRAFF NOT DEAD, повесив клоаку на свой сайт, обнаружил в логах, что при переходе из поиска Google подменяет IP пользователя, и запрос приходит от прокси самого Google.
Это не догадка — механизм официально описан. Chrome использует приватный прокси предзагрузки: браузер заранее подгружает страницы из выдачи через прокси-серверы Google, чтобы при клике страница открылась мгновенно. Google прямо документирует, что технология «relies on a CONNECT proxy which hides the user’s IP address from the website», и публикует список IP-адресов этих прокси, чтобы владельцы сайтов могли их распознавать.
Практический смысл: если ваша фильтрация считает такой запрос подозрительным, вы отсекаете часть живого целевого трафика из поиска — того самого, ради которого все делалось. Практику пришлось добавлять отдельное правило, чтобы не терять этих пользователей.
Отдельно стоит знать, что у Google есть механизм управления такой предзагрузкой со стороны сайта — специальный файл, которым владелец может регулировать долю пропускаемого прокси-трафика.
Защита от абузов и блокировок в сером SEO
Это та часть, ради которой клоаку в SEO чаще всего и ставят.
Против жалоб правообладателей. Логика в том, что информацию для жалобы собирают либо краулеры, либо люди по набору шаблонов. Если и те и другие видят пустую страницу, доказательная база не формируется. Практик, ловивший абузы на монобрендовые сайты, описывает это как основной мотив внедрения.
Против парсинга. Конкуренты и аналитические сервисы не снимают структуру, контент и схему ссылок.
Против блокировок. Здесь честности ради нужно сказать прямо: автор TRAFF NOT DEAD, тестировавший свою реализацию, писал про защиту от блокировок в сослагательном наклонении — «по идее должна защитить, тестирую». Подтвержденных данных, что клоака системно спасает от внесения домена в реестр, нет. Механизмы попадания в реестр разные, и часть из них вообще не требует захода на сайт.
Что до последствий для самого сайта: тот же автор отмечал, что за период наблюдения не заметил ни санкций в консоли вебмастера, ни падения показов. Это честное наблюдение, но у него есть срок — несколько месяцев на конкретных проектах. Ниже разберем, почему из него не следует вывод «клоака безопасна».
Как клоакинг в SEO палится
Здесь заканчивается практика и начинается то, что известно официально.
Определение через намерение. Google говорит про клоакинг так: «presenting different content to users and search engines with the intent to manipulate search rankings and mislead users». Ключевое слово — намерение. Именно оно отделяет клоаку от легальной подмены.
Способ реализации не имеет значения. Отдельно оговорено: «Cloaking counts whether you do it by server logic or by robots.txt, or any other method». То есть аргумент «у меня же не серверная клоака, а воркер» не работает.
Google умеет это детектить, и об этом есть исследование. В работе Google Research «Cloak of Visibility» описана система детекта клоакинга с точностью 95,5% и долей ложных срабатываний 0,9% на размеченном датасете почти в 95 тысяч адресов. Метод — сравнение контента, полученного разными профилями просмотра: с разными user-agent, из разных сетей, с разным реферером. В той же работе исследователи разобрали десять подпольных клоакинг-сервисов и обнаружили у них IP-блоклисты более чем на 50 миллионов адресов, связанных с поисковиками и security-краулерами.
Последнее особенно показательно: индустрия клоак-сервисов давно ведет базы «кого не пускать», а Google эти базы изучил и опубликовал работу о том, как их обходить со стороны краулера.
Оговорка для честности: работе 2016 года, и публичного описания того, как именно Google сравнивает выдачу в продакшене сегодня — с какой частотой, по каким триггерам — не существует. Утверждения в отраслевых статьях, что «SpamBrain сравнивает результаты краулера с реальным пользовательским опытом», официального подтверждения не имеют.
User-agent подделывают, и Google это знает. В документации сказано прямо: «the HTTP user-agent request header used by Googlebot is often spoofed». Поэтому официальный способ проверить бота — не смотреть на user-agent, а сделать обратный DNS-запрос по IP, убедиться, что домен принадлежит Google, затем сделать прямой запрос и сверить IP. Плюс Google публикует машиночитаемые списки своих диапазонов, которые регулярно обновляются.
Эта механика работает в обе стороны: ею пользуются и те, кто фильтрует ботов, и те, кто ловит фильтрующих.
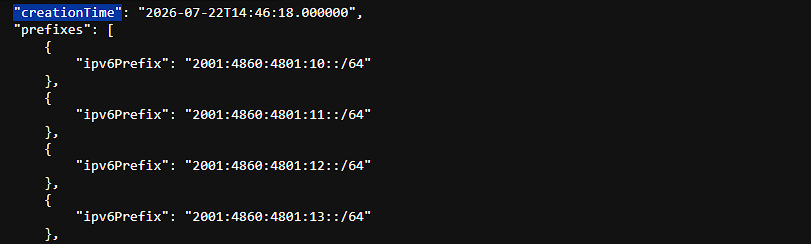
Официальные диапазоны адресов Googlebot: файл обновляется, дата видна прямо в нём
Санкция имеет конкретное имя. В отчете о ручных мерах есть отдельный тип — «Cloaking and/or sneaky redirects», описанный как сайт, который «показывает пользователям страницы, отличные от показанных Google, или перенаправляет пользователей на страницу, отличную от увиденной Google». Рядом стоят смежные типы: скрытые изображения, скрытые мобильные редиректы, несоответствие AMP-контента.
Исторический пример того, чем это кончается. В феврале 2006 года из индекса Google был удален немецкий сайт BMW — глава команды по борьбе с веб-спамом публично объявил об этом, причиной назывались дорвеи с редиректом пользователей. Сайт вернулся примерно через две недели после исправления и запроса на пересмотр. Кейсу двадцать лет, и он ценен не деталями, а прецедентом: масштаб бренда от деиндексации не защищает.
Где проходит граница дозволенного при настройке клоаки в SEO
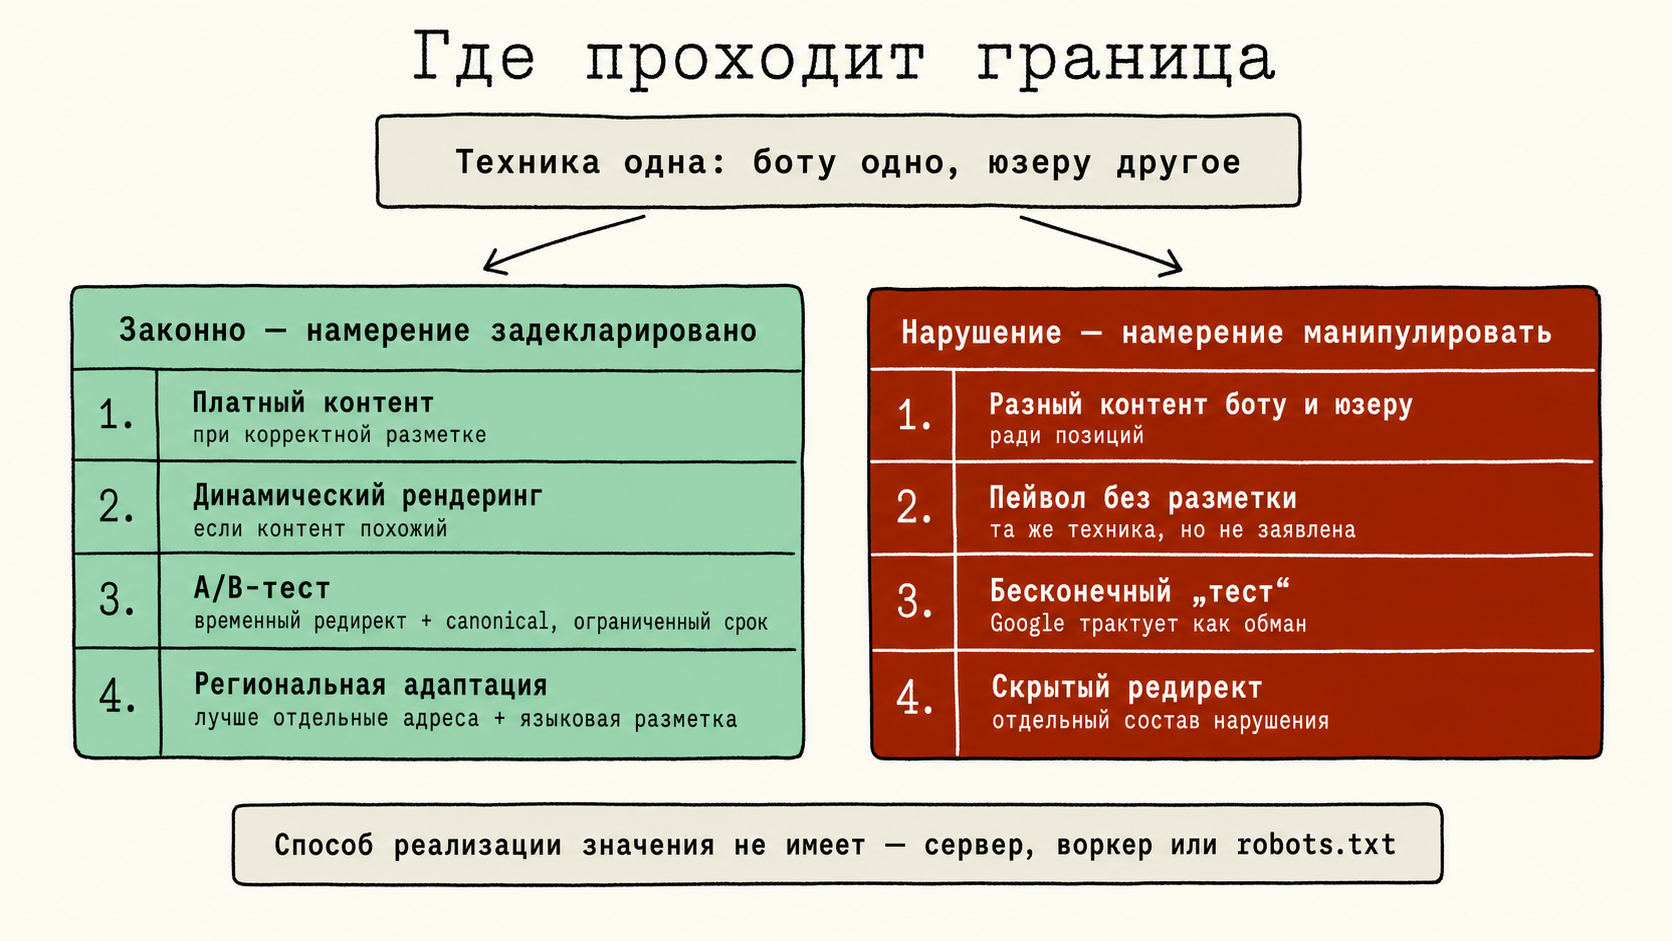
Одна и та же техника: с декларацией намерения законна, без неё — нарушение
Полезное упражнение — посмотреть, где та же техническая механика законна. Разница всегда в декларации намерения.
Платный контент. Показывать поисковику полный текст, а пользователю — обрезанный до оплаты, разрешено. Но при условии специальной разметки. Google формулирует прямо: эта разметка «helps Google differentiate paywalled content from the practice of cloaking, which violates spam policies». Та же самая подмена: с разметкой — легально, без нее — нарушение.
Динамический рендеринг. Отдавать боту предварительно отрисованную версию страницы допустимо, пока контент «похожий». Google уточняет: «Using dynamic rendering to serve completely different content to users and crawlers can be considered cloaking». Критерий — похожесть, а не идентичность.
A/B-тесты. Разрешены, но с правилами: временный редирект вместо постоянного, канонический тег на всех вариантах. И предупреждение: если тест идет неоправданно долго, Google может счесть это попыткой обмана.
Геотаргетинг. Адаптация под регион клоакингом не считается, но Google рекомендует отдельные адреса под локали с языковой разметкой. Нюанс, важный для грея: Googlebot не отправляет заголовок языка и краулит преимущественно с американских адресов — то есть строгая фильтрация по стране автоматически означает, что бот увидит не то, что пользователь.
Риски и цена
Риск первый: санкция. Не абстрактная, а с конкретным типом в отчете, ручным рассмотрением и заявкой на пересмотр, которую рассматривают неделями.
Риск второй: отложенность. Это главное, что стоит понять про наблюдения вида «полгода стоит, санкций нет». Детект не обязан срабатывать мгновенно, а спам-апдейты выходят волнами — последние прилетали в марте и июне 2026 года. Отсутствие санкции сегодня не является доказательством безопасности схемы, оно означает, что до вас пока не дошли.
Риск третий: потеря целевого трафика. Чем строже фильтр, тем больше живых пользователей отсекается. История с прокси предзагрузки — ровно этот случай: настроил слишком жестко и режешь тех, за кого платил.
Риск четвертый: инфраструктурный. Жалоба может уйти не только в поисковик, но и хостеру или регистратору. Клоака закрывает сайт от глаз, но не отменяет того, что домен зарегистрирован, а сервер кому-то принадлежит.
Риск пятый: ложное чувство контроля. Клоака создает ощущение, что проект защищен. При этом она не улучшает ни контент, ни ссылочное, ни позиции — она только откладывает встречу с проблемой.
Когда не стоит. Если проект строится вдолгую и под бренд. Если сайт уже получает существенный трафик — фильтр будет резать живых людей. Если у вас нет ресурса тестировать и поддерживать фильтрацию: неверная настройка убивает трафик тише и надежнее любой санкции.
Чек-лист оценки рисков
До внедрения
- Сформулировали, от кого именно защищаетесь: правообладатели, парсеры, регуляторы или все сразу.
- Понимаете, что позиции это не поднимет — задача только оборонительная.
- Оценили горизонт проекта: для долгого сайта под бренд цена ошибки выше выгоды.
- Знаете, что способ реализации не влияет на квалификацию нарушения.
При настройке
- Проверили, не режете ли трафик из поиска, идущий через прокси предзагрузки Google.
- Проверили, что поисковые краулеры стабильно получают целевую страницу, — иначе индексация встанет.
- Учли, что бот определяется не по user-agent, а по проверке адреса в обе стороны.
- Понимаете, что строгая фильтрация по стране означает: бот увидит не то же, что пользователь.
После
- Мониторите показы и позиции в консоли — падение может быть следствием фильтра, а не апдейта.
- Мониторите отчет о ручных мерах: тип «Cloaking and/or sneaky redirects» появится там.
- Не считаете отсутствие санкции за квартал доказательством безопасности.
- Держите план на случай санкции: что показываете при пересмотре и сколько стоит потеря домена.
Куда двигаться дальше
- Клоакинг в арбитраже трафика — та же техника в платном трафике.
- Сервисы для клоакинга: 12 решений — обзор рынка инструментов.
- Что такое дорвейный трафик — соседний состав нарушения.
FAQ
Чем клоакинг в SEO отличается от клоакинга в платном трафике?
Что такое money page и white page?
Клоакинг запрещен Google?
Как Google обнаруживает клоакинг?
Правда ли, что клоака защищает от блокировки РКН?
Можно ли законно показывать боту и пользователю разное?
Если санкций нет полгода — значит, схема рабочая?
Какая санкция прилетает за клоакинг?
Материалы по теме

Что такое клоака в арбитраже и зачем она нужна арбитражникам

Сервисы для клоакинга: 13 решений для разных задач






Вставить свои 5 копеек: